
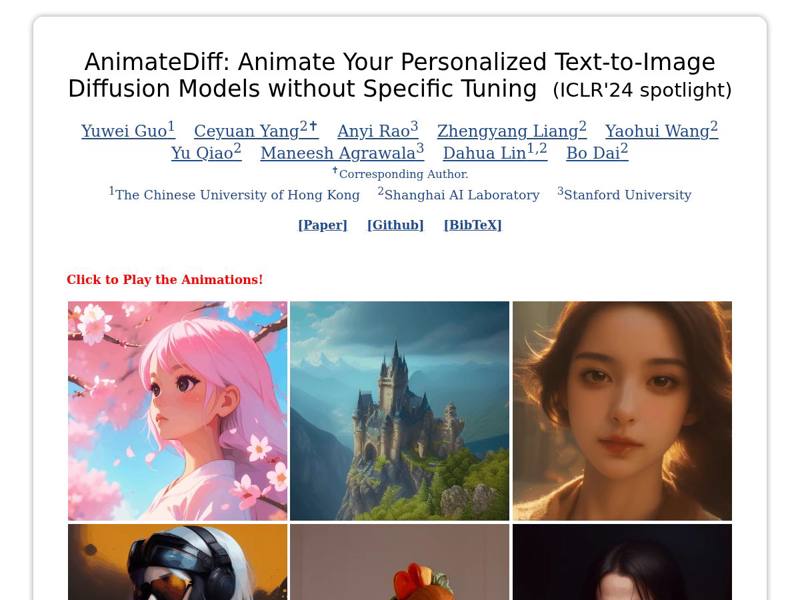
1. 网站简介
AnimateDiff 是一个学术研究项目的官方主页,由香港中文大学、上海人工智能实验室和斯坦福大学的研究者共同推出,相关论文发表于 ICLR 2024 并被评为 Spotlight。该项目旨在解决个性化文本到图像扩散模型的动画化难题,提出了一种无需针对具体模型进行额外调优即可生成高质量动画的通用框架。网站面向 AI 研究者和开发者,提供了完整的论文、代码和演示资源。
2. 主要功能/内容
- 方法论概述:网站详细阐述了 AnimateDiff 的技术路径。在冻结的基础扩散模型(如 Stable Diffusion)中新增一个运动建模模块,该模块通过视频片段进行训练,从中学到通用的运动先验。训练完成后,将此模块注入到任何基于同一基础模型的个性化版本中,即可将静态图像模型转化为动画生成模型,整个过程无需针对特定模型进行单独调优。
- 论文与代码:提供了论文的 PDF 链接、GitHub 代码仓库以及 BibTeX 引用信息,方便学者引用和复现实验。
- 动画示例画廊:展示了多种流行预训练模型(如 ToonYou、Lyriel、majicMIX Realistic、Realistic Vision、RCNZ Cartoon 等)生成的动画效果,用户点击即可播放,直观感受到不同风格下的动画质量。
- 多样性验证:为了证明该方法不会破坏原始模型的多样性,网站额外展示了在相同提示词和相同模型条件下生成的多组不同动画,说明模型依然保持较高的随机生成能力与创造性。
- 项目背景:页面中还提及了与 DreamBooth 等前序工作的关联,以及所采用的训练数据和实现细节。
3. 特点说明
- 高效通用:AnimateDiff 实现了“一次训练,普遍适用”的目标。运动模块从基础模型中解耦,使得所有基于同一底座模型的个性化变体都能直接受益,极大节省了大量单独微调的计算资源和时间。
- 视觉质量高:生成的动画在内容一致性、动作连贯性和风格保持方面均有出色表现,能够满足创意产业和艺术设计领域的高标准需求。
- 兼容性强:适用于 LoRA、DreamBooth 等多种个性化方法,可兼容 Stable Diffusion 生态下的各类社区模型,应用范围广泛。
- 开放共享:项目论文和代码完全开源,推动了文本生成图像到视频生成的研究进程,为后续学者提供了扎实的基础和丰富的参考。
总而言之,AnimateDiff 是一个兼具学术价值与应用潜力的项目,其网页内容组织清晰,演示资源丰富,非常适合 AI 研究者、开发者和创意工作者探访学习。