
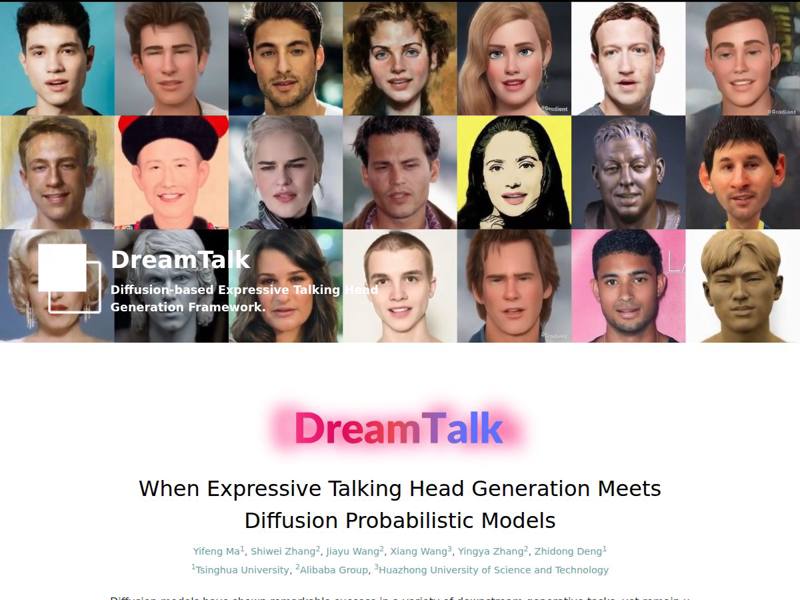
网站简介
DreamTalk 是一个由清华大学、阿里巴巴集团和华中科技大学联合开发的基于扩散模型的表情说话头部生成框架。该项目旨在利用扩散概率模型(Diffusion Probabilistic Models)解决生成具有丰富表情和精准唇形的说话头部(Talking Head)这一极具挑战性的任务。其研究成果已发布在 arXiv 上(论文编号:2312.09767),并公开了代码和预训练权重,供研究者和开发者使用。
主要功能/内容
DreamTalk 的核心功能是从音频生成逼真且具有多样化表情和说话风格的人脸视频。它通过三个关键组件实现这一目标:
- 去噪网络(Denoising Network):基于扩散模型,能够稳定地合成由音频驱动的高质量面部运动,覆盖不同表情。
- 风格感知唇部专家(Style-aware Lip Expert):在注意说话风格的同时,增强唇部运动的精准度和表现力,确保唇形与音频内容同步。
- 风格预测器(Style Predictor):同样基于扩散模型,直接从音频预测目标表情,无需参考视频或文本,极大减少了对外部风格参考的依赖。
网站展示了多项泛化能力,包括:
- 歌曲演唱:支持多语种歌曲,如中文歌曲《送别》,英文歌曲《Love Story》,粤语《上海滩》,日语《Lemon》等。
- 域外肖像:可处理非训练集风格的人物肖像。
- 多语言语音:支持中文、法语、德语、意大利语、日语、韩语和西班牙语等。
- 嘈杂音频:在包含噪声的音频输入下仍能保持生成效果。
此外,DreamTalk 还支持说话风格操控,包括调整无分类器引导(Classifier-free Guidance)的尺度、风格代码插值等,并可通过风格预测器自动预测目标说话风格。
特点说明
- 技术创新性:首次将扩散概率模型引入表情说话头部生成领域,通过精巧的设计充分释放了扩散模型在生成表达能力上的潜力。
- 高质量生成:能够生成照片级逼真的说话人脸,且唇部运动精准,整体效果超过现有的同类先进模型。
- 应用前景广阔:适用于 AIGC(人工智能生成内容)、虚拟数字人、影视动画制作、在线教育、游戏角色等多个领域。
- 开放共享:项目公开了代码、检查点(checkpoints)和论文,支持研究者复现和进一步开发。
总之,DreamTalk 是一个前沿的 AI 研究项目,展示了扩散模型在动态人脸生成方面的巨大潜力,为表情说话头部生成任务提供了一套创新且实用的解决方案。