
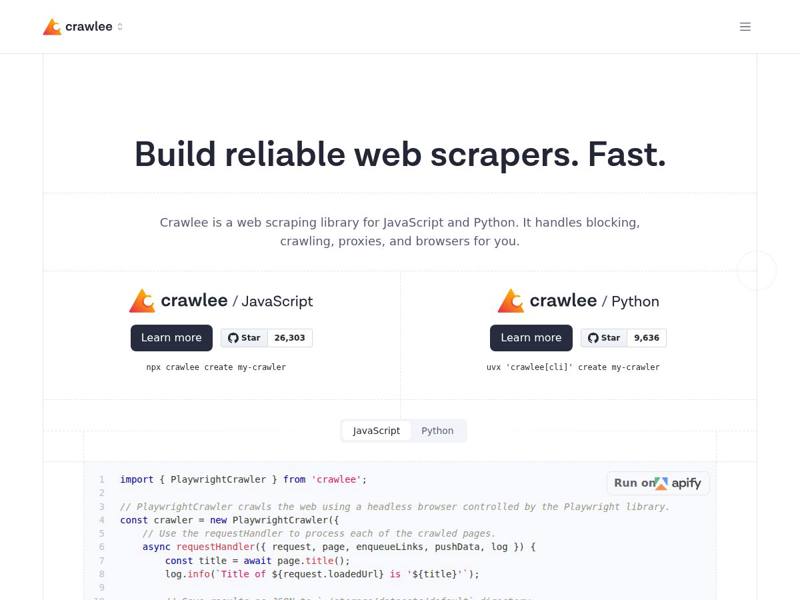
网站简介
Crawlee 是一个功能强大的开源 Web 爬虫库,专为 JavaScript 和 Python 开发者设计。它由 Apify 团队打造,旨在帮助用户快速构建和运维可靠的网络爬虫。作为一款经过生产环境验证的工具,Crawlee 提供了丰富的功能来应对真实世界中的爬虫挑战,包括请求阻塞处理、代理管理、浏览器自动化等。它永久免费且开源,是构建数据采集应用的理想选择。
主要功能/内容
1. 多语言支持
Crawlee 同时提供 JavaScript 和 Python 版本,开发者可以根据自己熟悉的技术栈选择。JavaScript 版通过 npx crawlee create my-crawler 即可快速创建项目,Python 版则使用 uvx 'crawlee[cli]' create my-crawler。
2. 自动处理爬虫痛点
- 请求阻塞处理:自动应对反爬机制,降低被屏蔽风险。
- 代理轮换:内置代理管理,支持会话恢复和 IP 轮换。
- 浏览器控制:通过 Playwright 集成,支持无头浏览器爬取动态页面。
3. 强大的爬虫类
Crawlee 提供了多种爬虫类,其中 PlaywrightCrawler 使用 Playwright 库控制无头浏览器,适用于需要执行 JavaScript 的现代网站。开发者只需定义 requestHandler 即可处理每个页面,轻松提取数据、保存结果、自动发现链接。
4. 数据导出与访问
爬取的数据可以轻松导出为 CSV 等格式,也可以直接通过 getData() 方法在代码中访问。默认数据存储到 ./storage/datasets 目录。
5. CLI 脚手架
通过命令行工具,用户可以快速生成项目模板,减少初始化工作,快速进入开发状态。
6. 丰富的文档和资源
网站提供详尽的文档、指南、示例和 API 参考,帮助开发者从入门到进阶。同时拥有社区支持,包括 Discord、Stack Overflow 等。
特点说明
- 开源免费:Crawlee 完全开源,采用永久免费许可,用户可以自由使用和定制。
- 可靠性优先:由每天抓取数百万页面的专业团队开发,工具经过大量实践检验,能应对真实场景的复杂问题。
- 易用性:提供简单直观的 API,配合 CLI 工具和丰富的示例,上手快。
- 生态兼容:与 Playwright 等主流浏览器自动化工具无缝集成,支持现代 Web 应用爬取。
- 灵活扩展:用户可以基于自己的需求定制爬虫行为,如限制请求数量、控制浏览器可见性等。
Crawlee 不仅是一个库,更是一套完整的爬虫解决方案,帮助开发者从繁琐的反爬对抗中解放出来,专注于数据业务本身。