
一、网站简介
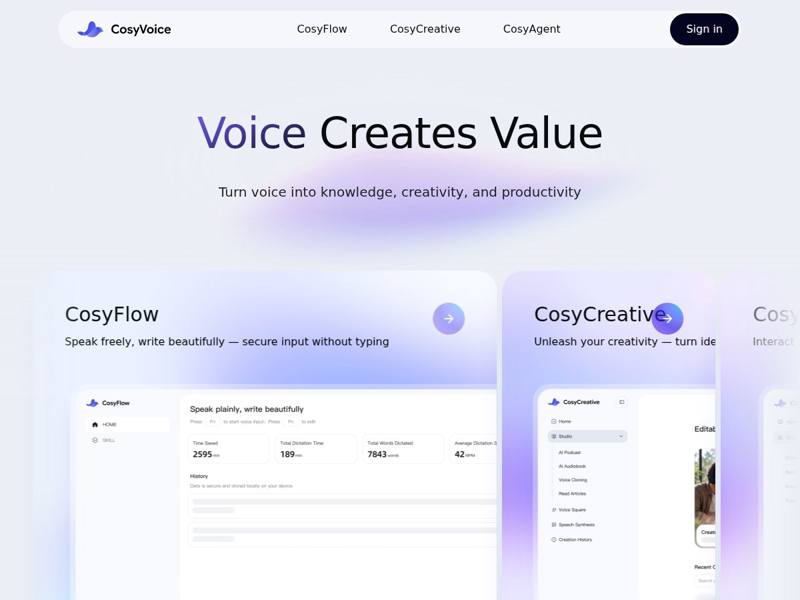
通义CosyVoice(简称 CosyVoice)是由阿里巴巴通义实验室开发的语音合成(TTS)大模型,是一个面向多语言、多场景的开源语音生成工具。该网站是 CosyVoice 项目的官方展示与资源页面,提供了模型介绍、技术文档、代码仓库、在线体验入口以及社区资源链接,旨在帮助开发者和普通用户快速了解并使用这一先进的语音合成技术。
CosyVoice 基于生成式大模型架构,将语音理解和语音生成能力统一到一个模型中,实现了从文本到语音的一体化生成。相比传统 TTS 系统,它在自然度、情绪表达、音色复刻等方面有显著提升,并被广泛用于有声内容生产、影视配音、虚拟角色语音、智能客服、教育辅导等众多领域。
二、主要功能/内容
1. 多语言语音合成
CosyVoice 支持中文、英文、日文、韩文等多种语言的语音合成,且支持中英文混合输入,能根据文本内容自动切换语言,生成符合语境和口音的高质量语音。这对于跨国内容创作和外语学习场景非常实用。
2. 声音复刻与个性化克隆
用户只需提供少量(如几秒到几十秒)的参考音频,即可让 CosyVoice 克隆该声音的音色、韵律和说话风格,生成相同音色的任意文本语音。这一功能被广泛用于有声书录制、虚拟主播创建、游戏角色配音等场景,大幅降低了声音制作门槛。
3. 情绪与风格控制
CosyVoice 支持丰富的情绪表达,如开心、悲伤、生气、惊讶等,同时可以控制语速、停顿、重音等细粒度韵律特征。通过自然语言描述或参数调节,用户可以指定语音的情感状态,让生成的语音更加生动真实。
4. 零样本语音生成
模型具备强大的零样本学习能力,即使没有针对特定说话人进行训练,也能基于给定的一段参考语音直接转换音色进行生成,无需微调,极大提升了易用性和实时性。
5. 开源与可定制
项目在 GitHub 上完全开源,提供完整的模型权重、推理代码和训练流程。开发者可以基于此进行二次开发,也可以根据自身数据微调模型以适配特定场景或语言,推动了语音合成技术的普及和创新。
6. 在线体验与社区支持
网站提供了在线体验入口,用户可以直接在网页上输入文本进行语音合成测试,无需搭建环境。同时附有详细的技术文档和示例,并支持开发者社区讨论,帮助用户快速上手。
三、特点说明
1. 高自然度与高表现力
CosyVoice 合成的语音接近真人发音,语调起伏自然,停顿合理,且能准确表达文本中的情感,避免了传统 TTS 常见的机械感和生硬感。
2. 高效易用
项目提供了简洁的 API 调用方式,同时支持本地部署和云端使用。对于普通用户,在线体验页面无需代码即可完成合成;对于开发者,几行 Python 代码就能实现完整调用。
3. 技术前沿
CosyVoice 采用了通义实验室自研的生成式语音模型架构,在多项公开评测中指标领先,代表了当前语音合成领域的前沿水平。
4. 开放生态
作为开源项目,CosyVoice 拥有活跃的开发者社区和丰富的衍生产品,用户可以基于它继续开发个性化应用,同时也能从社区中获取最新的技术进展和应用案例。
5. 安全可控
项目提供了音频溯源等安全功能,帮助维护创作者权益,并在模型发布时考虑了语音滥用风险,体现了负责任的 AI 开发理念。
四、总结
CosyVoice 作为一个功能强大且开放共享的语音合成大模型,为语音内容创作、AI 应用开发等领域提供了全新的工具和可能性。无论是个人创作者还是企业开发者,都能通过该网站快速接入最先进的语音技术,实现音色自由、语言自由、情感自由的高质量语音生成。该网站本身清晰全面地承载了项目相关的介绍、资源、体验和社区信息,是了解和运用 CosyVoice 的首选入口。