
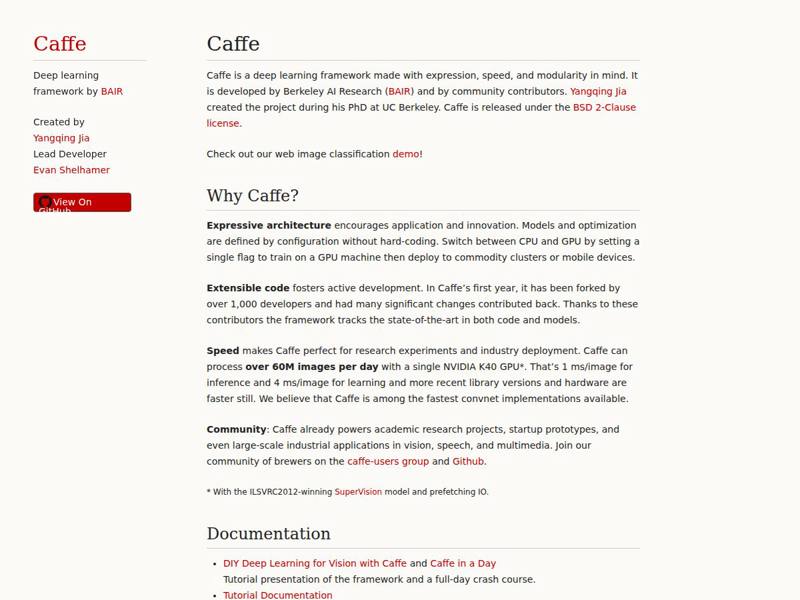
Caffe | Deep Learning Framework
网站简介
Caffe(Convolutional Architecture for Fast Feature Embedding)是一个清晰而高效的深度学习框架,由杨清佳(Yangqing Jia)在加州大学伯克利分校攻读博士期间创建,目前由伯克利人工智能研究中心(BAIR)及社区贡献者共同开发和维护。Caffe以**表达力(Expression)、速度(Speed)和模块化(Modularity)**为核心设计理念,旨在让研究人员和开发者能够快速构建和部署深度学习模型,尤其在卷积神经网络(CNN)领域表现突出。项目遵循BSD 2-Clause开源许可证,允许自由使用和修改。
主要功能/内容
1. 灵活的架构设计
- 模型定义简洁:通过配置文件(如.prototxt)定义网络结构和优化参数,无需硬编码,使模型易于复用和创新。
- CPU/GPU无缝切换:只需设置一个标志,即可在GPU上训练,然后部署到普通服务器或移动设备,极大简化了部署流程。
2. 超高的处理速度
- 官方宣称,使用单块NVIDIA K40 GPU,每天可处理超过6000万张图像(基于ILSVRC2012优胜的SuperVision模型),推理每张仅需1毫秒,训练每张约4毫秒,且较新的库版本和硬件速度更快。这使得Caffe非常适合大规模工业应用。
3. 丰富的文档和教程
- DIY Deep Learning for Vision with Caffe:面向视觉任务的深度学习入门教程。
- Tutorial Documentation:框架的实用指南和完整参考。
- arXiv / ACM MM '14论文:ACM多媒体开源竞赛的报告(arXiv:1408.5093)。
- 安装说明:支持Ubuntu、Red Hat、OS X等系统。
4. Model Zoo(模型动物园)
- BAIR推荐了一套标准的Caffe模型分发格式,并提供预训练模型,方便用户直接使用或微调。
5. API文档与开发指南
- 自动生成的开发文档和代码注释,帮助开发者二次开发。
- 包含性能基准测试,对比不同网络和GPU上的推理与训练结果。
6. 丰富的示例代码
- Notebook示例:图像分类、LeNet训练、风格识别微调、multilabel分类、模型参数编辑、R-CNN检测、Siamese网络嵌入等。
- 命令行示例:ImageNet、MNIST、CIFAR-10等经典数据集训练教程。
- C++ / Python API示例:包括C++分类演示、特征提取和Web演示(Flask服务器)。
7. 社区与引用
- 提供caffe-users讨论组,用于问答和使用交流;GitHub Issues用于开发讨论和bug提交。
- 网站提供了官方BibTeX引用格式,鼓励用户在论文中引用Caffe。
特点说明
- 模块化与可扩展性:Caffe的代码结构清晰,易于理解和扩展。发布第一年就被超过1000名开发者fork,大量重要贡献被合并回主线。
- 生产级应用:不仅用于学术研究,还支持创业原型和大型工业项目,覆盖视觉、语音和多媒体领域。
- 活跃的社区生态:拥有大量教程、预训练模型和第三方工具,形成了完整的深度学习解决方案。
- 专注视觉任务:Caffe在图像分类、目标检测、特征提取等方面具有显著优势,尤其适合卷积神经网络的研究与应用。
- 跨平台兼容:支持多种操作系统,并能在不同硬件配置下灵活运行。
Caffe作为深度学习领域的经典框架,虽然后续有PyTorch、TensorFlow等框架崛起,但它的设计理念和高效实现在计算机视觉发展中仍占有重要地位。该网站是学习和使用Caffe的官方权威资源,适合研究人员、学生和工程师参考。